Kurzantwort: Was ist ein Restore-Test?
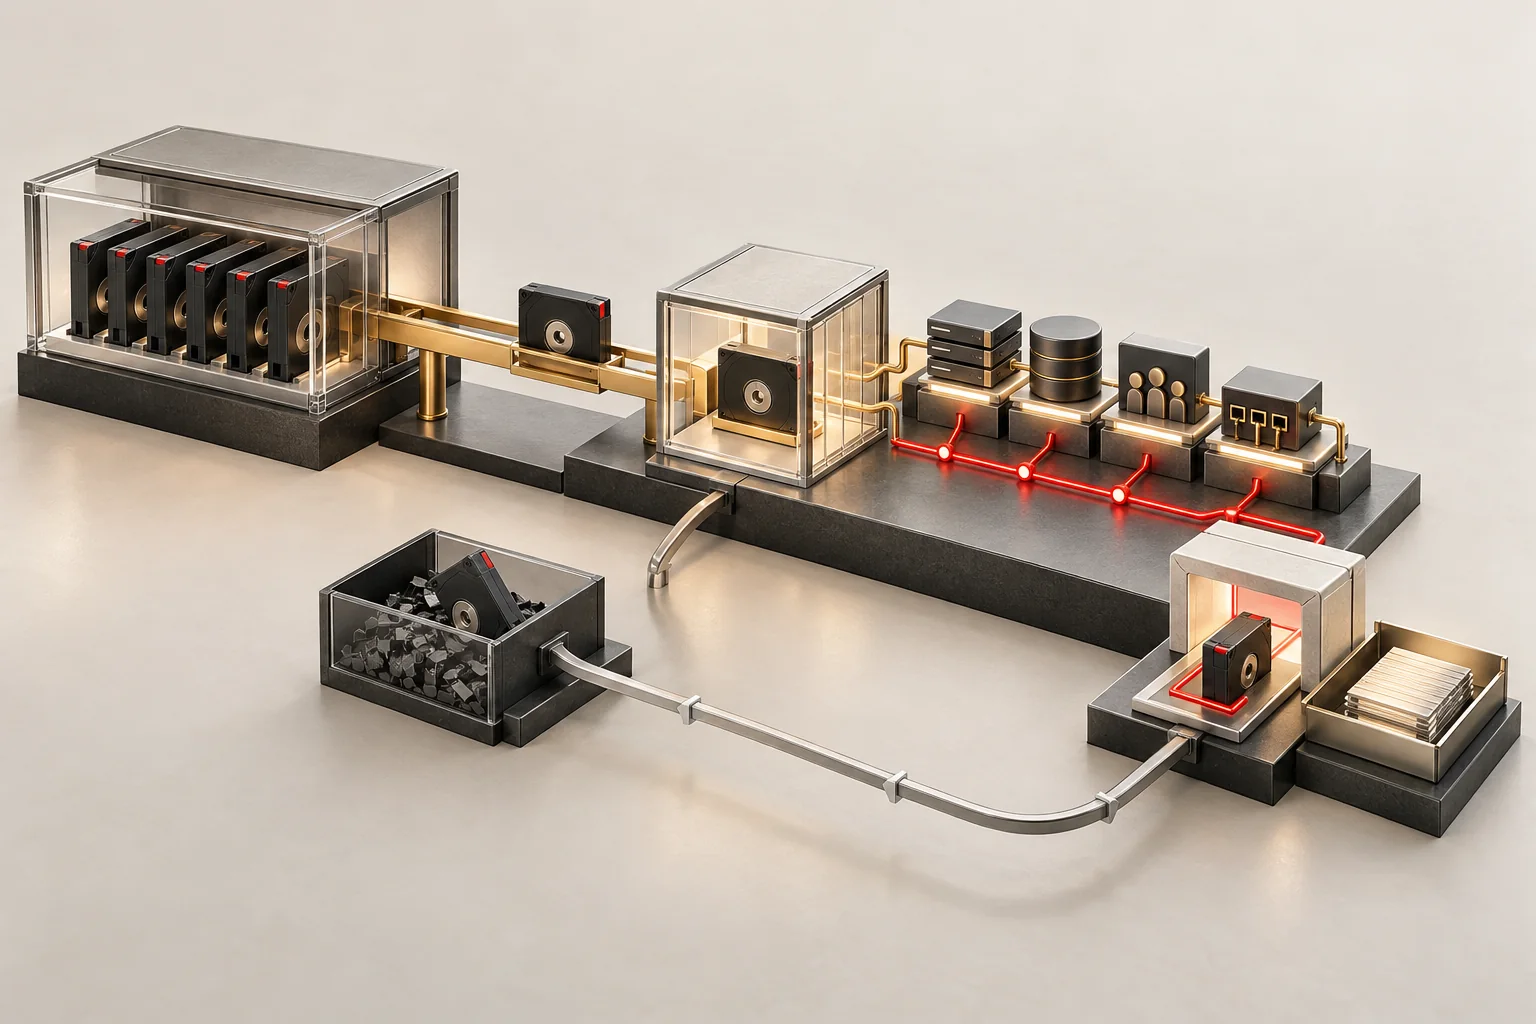
Ein Restore-Test ist eine geplante Wiederherstellung ausgewählter Daten, Systeme oder Anwendungen aus einer Sicherung. Er prüft, ob der gewünschte Datenstand erreichbar ist, wie lange die Wiederherstellung dauert und ob die betroffene Funktion danach fachlich nutzbar ist.
Das BSI verlangt in seinem Datensicherungskonzept nicht nur die Erstellung von Sicherungen, sondern auch die Planung des Restore. CISA empfiehlt, Verfügbarkeit und Integrität von Backups regelmäßig in einem Wiederherstellungsszenario zu testen. Daraus folgt kein pauschaler Turnus für jedes Unternehmen. Häufigkeit und Umfang müssen anhand der eigenen Risiken und Wiederanlaufziele bestimmt werden.
Backup-Status und Wiederherstellbarkeit getrennt bewerten
Eine Backup-Konsole kann Laufzeit, übertragenes Volumen und Jobstatus melden. Sie erkennt nicht automatisch, ob alle benötigten Datenquellen einbezogen wurden, Schlüssel verfügbar sind oder eine Anwendung mit dem gesicherten Stand konsistent startet. Auch ein Dateirestore beweist nicht, dass ein vollständiger Geschäftsprozess wieder funktioniert.
Ein Restore-Test beginnt deshalb mit einem konkreten Wiederanlaufziel. Statt ‚Backup testen‘ lautet der Auftrag beispielsweise: Die Auftragsbearbeitung soll aus einem definierten Sicherungsstand in einer getrennten Umgebung starten; Anmeldung, Datenbank, Dokumentenerzeugung und ein kontrollierter Testauftrag müssen funktionieren. Das macht Ergebnis und Abnahme überprüfbar.
RTO und RPO vom Geschäftsprozess ableiten
Das Recovery Point Objective (RPO) beschreibt, wie weit der wiederhergestellte Datenstand höchstens zurückliegen darf. Das Recovery Time Objective (RTO) beschreibt die angestrebte Zeit bis zur Wiederherstellung. Ein nächtliches Backup kann kein RPO von einer Stunde erfüllen. Ein enges Sicherungsintervall sagt umgekehrt nichts darüber aus, ob Anwendung und Abhängigkeiten innerhalb des RTO wieder anlaufen.
Geschäftsführung und Fachbereich legen fest, welche Unterbrechung und welcher Datenverlust für den jeweiligen Prozess tragbar sind. Die IT prüft, ob Sicherungsrhythmus, Übertragungsweg, Zielressourcen und Wiederherstellungsablauf diese Ziele technisch unterstützen. Unterschiede zwischen Vertrieb, Produktion, Finanzwesen und Archiv sind normal; ein einziger Wert für die gesamte IT ist meist zu grob.
Den Testumfang in Stufen planen
Nicht jeder Test muss die komplette Umgebung wiederherstellen. Eine belastbare Teststrategie kombiniert schnelle Stichproben mit anspruchsvolleren Anwendungstests und gelegentlichen Wiederanlaufübungen. Welche Stufe nötig ist, richtet sich nach Kritikalität, Änderungsrate, Architektur und bisherigen Befunden.
Rotieren Sie die Testobjekte. Wer immer nur dieselbe Datei zurückholt, prüft weder Datenbank noch Systemabbild, Identitätsabhängigkeit oder Wiederanlaufreihenfolge. Nach Migrationen, Versionswechseln, neuen Verschlüsselungsmechanismen oder geänderten Backup-Zielen sollte der betroffene Wiederherstellungsweg erneut getestet werden.
- Stufe 1: einzelne Datei, Postfach oder Datenbankobjekt aus einem bestimmten Zeitpunkt
- Stufe 2: kompletter Dienst mit Daten, Konfiguration und Berechtigungen
- Stufe 3: Anwendung mit Datenbank, Identität und ausgewählten Schnittstellen
- Stufe 4: Wiederanlauf mehrerer Systeme in der festgelegten Reihenfolge
- Stufe 5: abgestimmte Notfallübung mit Kommunikation, Freigabe und Ersatzverfahren
Ein realistisches, aber kontrollierbares Szenario wählen
Das Szenario beschreibt den angenommenen Ausfall und die verfügbaren Mittel. Beispiele sind eine versehentlich gelöschte Datei, eine beschädigte Datenbank, ein nicht mehr startender virtueller Server oder ein nicht verfügbarer Primärstandort. Für Ransomware-Szenarien muss zusätzlich geklärt sein, wie ein unbelasteter Sicherungsstand ausgewählt und eine erneute Infektion vermieden wird.
Wählen Sie für den Einstieg einen wichtigen, überschaubaren Dienst. Halten Sie fest, welche Abhängigkeiten praktisch getestet und welche nur dokumentarisch geprüft werden. Ein ehrlicher begrenzter Test ist aussagekräftiger als ein angeblicher Gesamttest, bei dem entscheidende Schnittstellen nicht verfügbar waren.
Eine isolierte Testumgebung und sichere Zugänge vorbereiten
Ein Routine-Restore darf den laufenden Betrieb nicht überschreiben. Die Zielumgebung benötigt ausreichend Rechenleistung, Speicher und passende Netzwerkgrenzen. Produktive Automatisierungen, E-Mail-Versand, Zahlungswege und externe Schnittstellen bleiben deaktiviert oder werden auf sichere Testziele umgeleitet.
Auch Datenschutz und Vertraulichkeit gelten in der Testumgebung. Zugriffe werden begrenzt, Testdaten nach Abschluss geregelt entfernt und Protokolle geschützt abgelegt. Verschlüsselungsschlüssel, Wiederherstellungskonten, Mehrfaktorverfahren und Notfallkontakte müssen verfügbar sein, ohne dauerhaft ungeschützt in der Produktionsumgebung zu liegen.
Den Restore-Test in sieben Schritten durchführen
Ein festes Ablaufmuster erleichtert Vergleich und Wiederholung. Zeitmessung beginnt nicht erst beim Kopieren der Daten, sondern mit dem vereinbarten Auslösepunkt. Auch Suche nach Dokumentation, Freigabe, Bereitstellung der Zielumgebung und fachliche Abnahme beeinflussen den echten Wiederanlauf.
- 1. Testziel, Szenario, Datenstand, RTO, RPO und Erfolgskriterien freigeben.
- 2. Zielumgebung, Zugänge, Schutzgrenzen, Kommunikationsweg und Abbruchkriterien prüfen.
- 3. Passenden Sicherungsstand auswählen und seine Herkunft dokumentieren.
- 4. Daten, Konfiguration und Systeme in der vorgesehenen Reihenfolge wiederherstellen.
- 5. Integrität, Startfähigkeit, Berechtigungen und technische Abhängigkeiten kontrollieren.
- 6. Einen definierten Fachprozess durch den zuständigen Bereich abnehmen lassen.
- 7. Zeiten, Abweichungen, Restarbeiten und verantwortliche Korrekturen protokollieren.
Technische Prüfung und fachliche Abnahme verbinden
Die technische Prüfung kontrolliert unter anderem Datenmenge, Prüfsummen oder Konsistenz, Dienstzustände, Berechtigungen, Protokolle und Schnittstellen. Sie beantwortet, ob die Komponenten erwartungsgemäß arbeiten. Die fachliche Abnahme beantwortet, ob ein zulässiger Geschäftsvorgang mit dem wiederhergestellten Stand tatsächlich bearbeitet werden kann.
Dafür definiert der Fachbereich vorab einen ungefährlichen Prüffall. In einer Warenwirtschaft kann das Öffnen eines Testauftrags, die Prüfung von Positionen und die Erzeugung eines Testdokuments dazugehören. Der Test darf keine echten Lieferungen, Buchungen oder Kundenkommunikation auslösen. Technischer und fachlicher Befund werden getrennt dokumentiert.
Das Testprotokoll als Entscheidungsgrundlage nutzen
Das Protokoll nennt Szenario, Sicherungsstand, beteiligte Systeme, Start- und Endzeiten, verwendete Dokumentation, technische Ergebnisse, fachliche Abnahme und Abweichungen. Es unterscheidet zwischen bestanden, eingeschränkt bestanden und nicht bestanden. Screenshots aus der Backup-Konsole reichen dafür nicht.
Jeder Befund erhält eine Maßnahme, Verantwortung und Frist. Fehlende Schlüssel können eine Zugangsänderung auslösen; zu lange Bereitstellung kann vorgehaltene Zielressourcen nötig machen; unvollständige Daten können Sicherungsumfang oder Anwendungsstilllegung vor dem Backup verändern. Der nächste Test prüft ausdrücklich, ob die Korrektur wirksam wurde.
Testtermine nach Risiko und Veränderung festlegen
Ein fester Mindesttermin verhindert, dass Restore-Tests im Tagesgeschäft verschwinden. Ergänzend werden ereignisabhängige Auslöser festgelegt: neue Anwendung, größere Migration, Wechsel der Backup-Lösung, geänderte Verschlüsselung, neue Identitätsplattform oder ein fehlgeschlagener Wiederherstellungsversuch.
Der Turnus muss zur Kritikalität und Veränderung passen. Häufige kleine Stichproben und seltener umfangreiche Übungen können sinnvoll kombiniert werden. Entscheidend ist nicht eine allgemeine Monats- oder Jahreszahl, sondern ob alle wichtigen Wiederherstellungswege in einem nachvollziehbaren Zyklus praktisch nachgewiesen werden.
Checkliste für den nächsten Wiederherstellungstest
Wenn mehrere Punkte nicht eindeutig beantwortet werden können, sollte zunächst der Testumfang begrenzt und vorbereitet werden. Ein ungeplanter Eingriff in Produktion ist kein Ersatz für fehlende Grundlagen.
- Ist der betroffene Geschäftsprozess samt Systemabhängigkeiten dokumentiert?
- Sind RTO, RPO, Sicherungsstand und Erfolgskriterien festgelegt?
- Existieren eine geeignete Zielumgebung und ausreichende Ressourcen?
- Sind Schlüssel, Konten, Lizenzen, Installationsquellen und Dokumentation verfügbar?
- Sind produktive Schnittstellen und automatische Aktionen sicher begrenzt?
- Ist geklärt, wer technisch prüft und wer fachlich abnimmt?
- Gibt es Abbruch-, Bereinigungs- und Eskalationswege?
- Werden Ergebnis, Zeiten, Lücken und Korrekturen nachvollziehbar festgehalten?
Quellen und fachliche Grundlagen
Für die rechtliche und technische Einordnung wurden die folgenden Primärquellen herangezogen. Der Beitrag ersetzt keine Prüfung des konkreten Einzelfalls.
- Bundesamt für Sicherheit in der Informationstechnik: CON.3 Datensicherungskonzept, Stand Februar 2022
- National Institute of Standards and Technology: SP 800-34 Rev. 1 – Contingency Planning Guide for Federal Information Systems, Mai 2010, aktualisiert November 2010
- Cybersecurity and Infrastructure Security Agency: StopRansomware Guide, abgerufen am 22. Oktober 2026