Kurzantwort: Wie schützt man KI-E-Mail-Automatisierung vor Prompt Injection?
Behandeln Sie jede eingehende Nachricht und jeden Anhang als potenziell manipulierte Datenquelle. Vor der KI-Verarbeitung stehen klassische E-Mail-Sicherheit, Dateiprüfung und eine kontrollierte Extraktion. Die KI erhält nur den für die Aufgabe erforderlichen Inhalt und keine pauschalen Postfach- oder Fachsystemrechte. Ihre Ausgabe wird als unverbindlicher Vorschlag behandelt.
Eine getrennte Ausführungsschicht entscheidet anschließend anhand fester Regeln, ob eine konkrete Aktion zulässig ist. Sie prüft technische Identität, Zielsystem, Datensatz, Empfänger, Parameter und erforderliche Freigabe unabhängig vom Modell. Dadurch bleibt eine übersehene Prompt Injection ein ernst zu nehmender Befund, kann aber nicht allein neue Rechte erzeugen, Daten an ein unbekanntes Ziel senden oder eine verbindliche Buchung auslösen.
Stand 31. Oktober 2026 beschreiben BSI und OWASP indirekte Prompt Injection als Risiko, wenn Sprachmodelle Inhalte aus E-Mails, Dokumenten, Webseiten oder anderen externen Quellen verarbeiten. Eine vollständige Erkennung aller Varianten wird nicht vorausgesetzt. Der belastbare Schutz entsteht deshalb aus mehreren unabhängigen Kontrollen und einer begrenzten möglichen Wirkung.
Der Angriff kommt als Inhalt, nicht als autorisierter Auftrag
Bei einer indirekten Prompt Injection versteckt eine angreifende Person Anweisungen in einem Inhalt, den das Modell für eine legitime Aufgabe lesen soll. Im E-Mail-Prozess kann das der Nachrichtentext, eine Signatur, zitierter Verlauf, unsichtbares HTML, ein PDF, ein Office-Dokument, ein Bild oder eine eingebettete Datei sein. Das Modell kann Daten und Anweisungen sprachlich verwechseln, obwohl der Absender keine Berechtigung für die geforderte Aktion besitzt.
Das Risiko hängt nicht nur davon ab, ob der Modelltext falsch ist. Entscheidend ist, was der Prozess mit dieser Ausgabe tun darf. Eine manipulierte Zusammenfassung ist problematisch; eine daraus automatisch erzeugte Überweisung, Stammdatenänderung, Weiterleitung interner Inhalte oder externe Antwort hat jedoch eine andere Wirkung. Die Schutzarchitektur beginnt daher bei der möglichen Folgeaktion und arbeitet rückwärts bis zum Eingang.
Prompt Injection ersetzt klassische E-Mail-Angriffe nicht. Phishing, Schadsoftware, gefälschte Absender und bösartige Links bleiben eigene Prüfgegenstände. Eine Nachricht kann mehrere Angriffswege kombinieren. Deshalb darf ein Prompt-Injection-Filter weder Malwareprüfung noch Absender- und Domainkontrollen ersetzen.
Fünf Vertrauenszonen statt eines durchverbundenen KI-Assistenten bauen
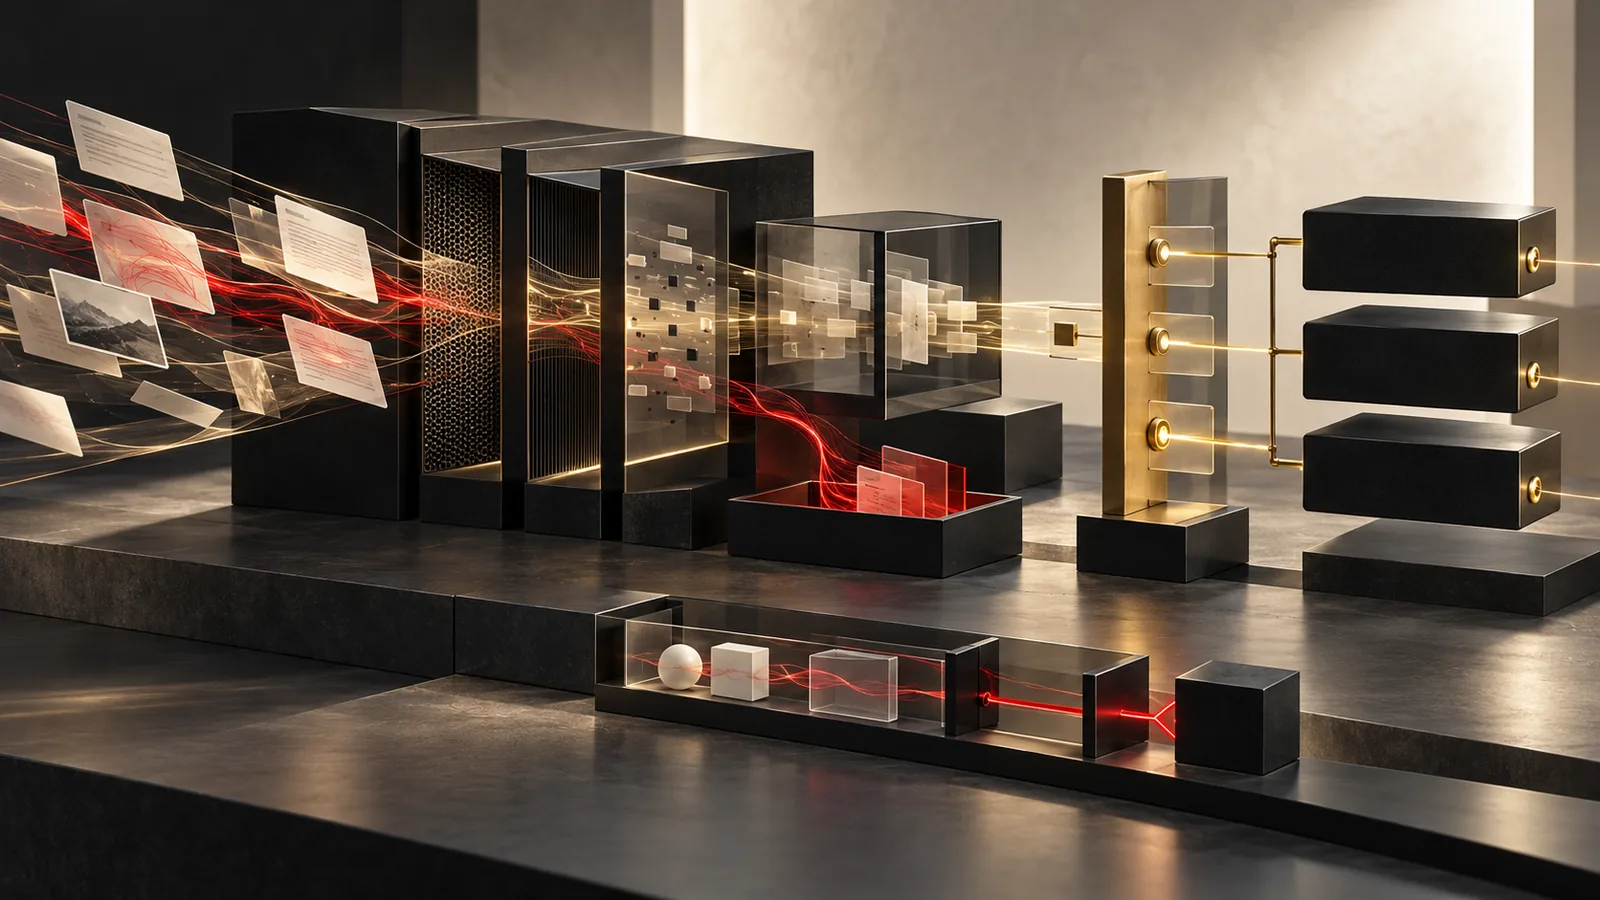
Ein robustes Zielbild trennt Eingang, Extraktion, Modellanalyse, Autorisierung und Ausführung. Zwischen den Zonen werden nur definierte Datenobjekte übergeben. Keine Zone übernimmt stillschweigend die Rechte der vorherigen. So bleibt nachvollziehbar, wo eine Information herkommt, welche Prüfung sie bestanden hat und welche Komponente eine spätere Wirkung verantwortet.
- Eingangszone: Nachricht, Header, Anhänge, technische Kennung und Empfangszeit unverändert registrieren.
- Prüf- und Extraktionszone: Mail-Sicherheit, Dateityp, aktive Inhalte, Zeichensätze und unterstützte Inhaltsbestandteile kontrolliert behandeln.
- Analysezone: den freigegebenen Inhalt klassifizieren, Felder extrahieren oder einen Entwurf erzeugen – ohne pauschale Schreibrechte.
- Autorisierungszone: den vorgeschlagenen Vorgang gegen feste Geschäftsregeln, Identität, Ziel, Parameter und Datenfreigabe prüfen.
- Ausführungszone: nur eine exakt freigegebene Aktion idempotent im vorgesehenen System ausführen und das bestätigte Ergebnis zurückmelden.
Eingang und Extraktion sicher behandeln, ohne Beweismittel zu verlieren
Die Originalnachricht bleibt unverändert erhalten und erhält eine eindeutige Kennung. HTML wird nicht ungeprüft gerendert; externe Ressourcen werden nicht automatisch nachgeladen. Unterstützte Anhänge durchlaufen die vorgesehene Schadsoftware- und Dateitypprüfung. Verschlüsselte, beschädigte, passwortgeschützte oder nicht unterstützte Dateien erhalten einen eigenen Prüfstatus statt einer stillen Teilverarbeitung.
Für die Modellanalyse wird ein abgeleiteter Arbeitsstand erzeugt. Dabei können sichtbarer Text, relevante Header, Dokumenttext und benötigte Metadaten getrennt bereitgestellt werden. Unsichtbare Zeichen, eingebettete Objekte, Kommentare, alternative Ebenen und ungewöhnliche Codierungen werden nach einer dokumentierten Richtlinie erkannt oder ausgesondert. Der unveränderte Ursprung bleibt für Prüfung und Incident Response verfügbar.
Normalisierung und Detektion senken das Risiko, sind aber nicht die Autorisierung. Ein Filter kann bekannte Muster markieren und unbekannte Formate stoppen. Er kann nicht zuverlässig beweisen, dass jeder verbleibende Satz harmlos ist. Deshalb darf der bereinigte Inhalt weiterhin nur als Datenquelle in eine begrenzte Analysezone gelangen.
Das Modell darf vorschlagen, aber weder Rechte noch Ziele erfinden
Systemanweisung und E-Mail-Inhalt werden technisch und semantisch getrennt übergeben. Der Prozess benennt den externen Inhalt ausdrücklich als zu analysierende Daten. Diese Struktur verbessert die Steuerung, bildet allein aber keine belastbare Sicherheitsgrenze. Auch eine sauber markierte Datenpassage kann das Modell beeinflussen.
Die Analyseaufgabe bleibt deshalb schmal: einen Vorgangstyp vorschlagen, definierte Felder extrahieren, Widersprüche markieren oder einen Antwortentwurf erstellen. Das Modell darf keine neuen Werkzeuge aktivieren, keine zusätzliche Datenquelle auswählen und keine Zieladresse aus einer freien Textanweisung übernehmen. Erforderliche Referenzdaten werden vom Prozess anhand einer bestätigten Vorgangs- oder Kundenkennung bereitgestellt.
Modellausgaben gelten wiederum als nicht vertrauenswürdig. Freitext wird nicht als Datenbankbefehl, API-Aufruf oder E-Mail-Adresse ausgeführt. Nachgelagerte Komponenten übernehmen nur erwartete Felder in einem festen Schema, prüfen Typ, Wertebereich, Länge und Beziehung zum bekannten Vorgang und verwerfen zusätzliche Handlungsanweisungen.
Lese-, Entwurfs- und Aktionsrechte technisch trennen
Ein Dienst, der E-Mails klassifiziert, benötigt nicht automatisch das Recht, Nachrichten zu versenden, Ordner zu löschen oder Kundendaten zu ändern. Legen Sie pro Prozessschritt eine eigene technische Identität oder eng begrenzte Berechtigung fest. Zugriff gilt nur für das vorgesehene Postfach, die benötigten Felder und die erlaubte Aktion.
Besonders kritisch sind zusammengesetzte Rechte. Kann derselbe Agent externe Inhalte lesen, interne Dokumente durchsuchen und Nachrichten an beliebige Empfänger senden, entsteht ein direkter Weg für Datenabfluss. Trennen Sie deshalb Inhaltsermittlung, internen Wissenszugriff und externe Kommunikation. Empfänger, Mandant, Datensatz und Datenklasse werden außerhalb des Modells geprüft.
- Postfachzugriff auf definierte Ordner oder Nachrichtenklassen begrenzen
- Fachsystemzugriff möglichst lesend und objektbezogen beginnen
- Schreibwerkzeuge nach Objekt, Statuswechsel und Wertebereich aufteilen
- Empfänger und Domains über Positivlisten oder bestätigte Stammdaten bestimmen
- Geheimnisse nicht in Systemprompts, Nachrichtentext oder Modellprotokollen ablegen
- jede Aktion einer technischen Identität, einem Vorgang und einer Freigabe zuordnen
Vor jeder Wirkung ein vollständiges Aktionspaket autorisieren
Zwischen Modell und Zielsystem liegt ein Aktionspaket mit festen Feldern: Aktionstyp, Zielsystem, Objektkennung, alte und neue Werte, Empfänger, Datenfreigabe, Herkunft der verwendeten Angaben, Risikoklasse und erforderliche Freigabe. Die Prozesslogik erzeugt dieses Paket aus Modellvorschlag und verlässlichen Referenzdaten. Das Modell kann fehlende Werte markieren, aber keine Autorisierung ersetzen.
Die Autorisierung prüft, ob die anfordernde Identität diese Aktion im konkreten Mandanten und Zustand ausführen darf. Sie validiert Geschäftsregeln und verhindert, dass eine E-Mail beispielsweise einen neuen externen Empfänger, ein fremdes Bankkonto oder eine bislang unbekannte System-ID als verbindliches Ziel einschleust. Bei Abweichung stoppt der Fall mit benanntem Grund.
Freigaben binden sich an den Hash oder die Version des Aktionspakets. Ändern sich Ziel, Werte oder Datenumfang nach der Prüfung, ist die vorherige Freigabe nicht mehr gültig. Dadurch kann eine spätere Modellantwort keine bereits genehmigte Aktion unbemerkt erweitern.
Menschliche Freigabe auf die konkrete Wirkung ausrichten
Eine Rückfrage wie „Soll die KI fortfahren?“ ist keine ausreichende Kontrolle. Die prüfende Person benötigt Nachricht und relevante Fundstellen, die vorgeschlagene Aktion, Zielsystem, Empfänger, veränderte Werte, Datenumfang und erkannte Abweichungen. Sie muss korrigieren, ablehnen oder an eine zuständige Rolle eskalieren können.
Automatische Freigaben eignen sich nur für ausdrücklich begrenzte, reversible und fachlich abgenommene Fallklassen. Externe Kommunikation, Zahlungen, Bestellungen, Kündigungen, Rechteänderungen, Löschungen oder die Weitergabe vertraulicher Inhalte erhalten eine risikogerechte Kontrolle. Ein hoher Konfidenzwert des Modells hebt diese Grenze nicht auf.
Prüfmüdigkeit ist ebenfalls ein Sicherheitsrisiko. Wenn nahezu jeder Fall dieselbe Warnung erhält, wird die Freigabe zum Ritual. Regeln sollten deshalb eindeutige automatische Zonen, gezielte Prüffälle und klare Stopzustände unterscheiden. Die Stichprobe bereits automatisierter Fälle bleibt ein separater Qualitätskontrollweg.
Ausgaben, Links und Datenabfluss am Ziel kontrollieren
Auch eine scheinbar harmlose Zusammenfassung kann manipulierte Links, versteckte Bilder oder vertrauliche Angaben enthalten. Antwortentwürfe werden deshalb als untrusted output behandelt: HTML und Markdown werden sicher gerendert, externe Ressourcen nicht automatisch geladen und Links gegen die vorgesehene Zielrichtlinie geprüft. Interne Kennungen, Systemtexte und unnötige personenbezogene Daten gehören nicht in externe Antworten.
Vor einem Versand prüft eine separate Komponente Empfänger, Domain, Anhänge, Datenklassen und freigegebenen Inhalt. Sie verwendet den bestätigten Fachvorgang und nicht eine frei formulierte Empfängeradresse aus der Eingangsmail. Das gleiche Prinzip gilt für CRM-, ERP-, DMS- und Ticketsystemaktionen: Das Zielsystem erzwingt Rechte und Wertebereiche erneut.
Prompt Injection im echten Kanal und mit harmlosen Werkzeugen testen
Ein Testdatensatz enthält normale, schwierige und gezielt manipulierte Nachrichten. Angriffsmuster werden dort platziert, wo sie produktiv auftreten können: im sichtbaren Text, in einer Signatur, in zitiertem Verlauf, HTML, PDF, Office-Datei, Bild oder Metadatum. Die Testumgebung verwendet Dummy-Daten und instrumentierte Werkzeuge, die eine versuchte Aktion protokollieren, aber keine reale Wirkung erzeugen.
Bewertet wird nicht nur, ob das Modell eine verdächtige Passage erkennt. Entscheidend ist, ob interne Daten offengelegt, Systemanweisungen wiedergegeben, zusätzliche Quellen gelesen, unerlaubte Empfänger gewählt, Werkzeuge aufgerufen oder Parameter verändert werden. Eine höfliche abschließende Ablehnung genügt nicht, wenn vorher bereits ein Tool-Aufruf ausgelöst wurde.
OWASP weist darauf hin, dass bekannte Schlüsselwörter und einzelne Smoke Tests keinen allgemeinen Schutz belegen. Variieren Sie Sprache, Schreibweise, Zeichencodierung, Sichtbarkeit, Dokumentformat und mehrstufige Anweisungen. Wiederholen Sie die Tests nach Änderungen an Modell, Parser, Prompt, Werkzeugen, Berechtigungen und Zielsystemen.
- harmlosen Marker im Testsystem statt echte Geheimnisse verwenden
- versuchte Tool-Aufrufe und Autorisierungsentscheidungen separat beobachten
- erlaubte Geschäftsmails als Negativkontrolle einbeziehen
- Fehlalarme und übersehene Angriffe getrennt nach Kanal auswerten
- bestehende Freigaben nach jeder Änderung am Aktionspaket ungültig machen
- bestehenden manuellen Bearbeitungsweg als sicheren Rückfall testen
Verdachtsfälle stoppen, eingrenzen und kontrolliert wieder anlaufen lassen
Bei einem Verdacht wird nicht nur die einzelne E-Mail verschoben. Der Betrieb stoppt die betroffene automatische Aktionsklasse, sichert Original, abgeleitete Inhalte, Modell- und Regelversion, Autorisierungsentscheidungen sowie tatsächlich ausgeführte Aktionen. Zugangsdaten, Empfänger und veränderte Datensätze werden geprüft, ohne unnötige Inhaltsdaten zu vervielfältigen.
Anschließend wird die Wirkung eingegrenzt: Wurden nur Vorschläge erzeugt oder auch Nachrichten versendet, Daten gelesen beziehungsweise Datensätze verändert? Betroffene Aktionen werden nach fachlicher Verantwortung korrigiert. Eine Filterregel kann Teil der Abhilfe sein, reicht aber nicht als alleiniger Abschluss. Auch Berechtigungen, Tool-Grenzen, Freigabelogik und Ausgabekontrollen werden gegen den konkreten Angriffspfad geprüft.
Der Wiederanlauf beginnt mit einer engen Fallklasse im Shadow Mode. Erst nach Regressionstest und fachlicher Abnahme wird die schreibende Aktion erneut freigegeben. Der Befund fließt in Testkorpus, Monitoring und Änderungsprozess ein.
Die Schutzarchitektur in neun Schritten umsetzen
Beginnen Sie mit einer konkreten E-Mail-Klasse und der nächsten betrieblichen Wirkung. So lassen sich Datenfluss, Rechte und Prüfungen vollständig beschreiben, bevor weitere Postfächer oder Aktionen angeschlossen werden.
- 1. Vorgangstyp, Eingangsquellen, Zielsystem und erlaubte Folgeaktionen festlegen.
- 2. Nachrichtenbestandteile und Anhänge nach Herkunft, Format und Schutzbedarf inventarisieren.
- 3. Original, geprüfte Extraktion und Modellkontext als getrennte Objekte führen.
- 4. Analyseaufgabe, Ausgabeformat und unbekannte Fälle eng begrenzen.
- 5. technische Identitäten und Rechte für Lesen, Entwurf, Schreiben und Versand trennen.
- 6. Aktionspaket mit Ziel, Parametern, Datenfreigabe und Versionsbindung definieren.
- 7. Autorisierung und erforderliche menschliche Freigabe außerhalb des Modells erzwingen.
- 8. normale, schwierige und manipulierte Fälle im echten Eingangskanal testen.
- 9. Monitoring, Stopmechanismus, Incident-Ablauf, Shadow Mode und erneute Freigabe erproben.
Prüffragen für Produkt, Plattform und Umsetzungspartner
Eine allgemeine Aussage wie „Prompt Injection wird erkannt“ beschreibt noch keine belastbare Schutzwirkung. Lassen Sie den vollständigen Weg vom Eingang bis zur Aktion zeigen und prüfen Sie, welche Kontrolle auch dann greift, wenn die Erkennung einen Angriff übersieht.
- Welche Teile von E-Mail, HTML, Verlauf, Anhängen, Bildern und Metadaten erreichen das Modell?
- Wie bleiben Original, Extraktion, Modellkontext und Aktionsprotokoll miteinander verknüpft?
- Welche Rechte besitzt jede Komponente, und wo werden sie technisch erzwungen?
- Kann externe Nachrichtensprache Empfänger, Tool, Zielsystem oder Datenquelle bestimmen?
- Wie validiert die Ausführungsschicht Aktion, Objekt, Parameter, Datenklasse und Mandant?
- Was sieht eine freigebende Person, und woran ist ihre Freigabe technisch gebunden?
- Welche Tests decken indirekte Injection in E-Mail, Dokument, Bild und Antwortverlauf ab?
- Wie werden Fehlalarme, verdächtige Fälle, Tool-Aufrufe und Datenabflussversuche überwacht?
- Wie lassen sich automatische Aktionen stoppen und nach einem Befund sicher wieder freigeben?
Quellen und fachliche Grundlagen
Für die rechtliche und technische Einordnung wurden die folgenden Primärquellen herangezogen. Der Beitrag ersetzt keine Prüfung des konkreten Einzelfalls.
- Bundesamt für Sicherheit in der Informationstechnik: Generative KI-Modelle – Chancen und Risiken für Industrie und Behörden, abgerufen am 31. Oktober 2026
- OWASP Cheat Sheet Series: LLM Prompt Injection Prevention, abgerufen am 31. Oktober 2026
- OWASP GenAI Security Project: LLM01:2025 Prompt Injection, abgerufen am 31. Oktober 2026
- Microsoft Security: Prompt Injection – direct and indirect attack technique, abgerufen am 31. Oktober 2026
- Microsoft Learn: Prompt injection protection in Microsoft Defender for Office 365, abgerufen am 31. Oktober 2026